달력

9

« 2026/9 »

  • 1
  • 2
  • 3
  • 4
  • 5
  • 6
  • 7
  • 8
  • 9
  • 10
  • 11
  • 12
  • 13
  • 14
  • 15
  • 16
  • 17
  • 18
  • 19
  • 20
  • 21
  • 22
  • 23
  • 24
  • 25
  • 26
  • 27
  • 28
  • 29
  • 30
2026. 9. 16. 10:14

사회적 지능이 낮은 사람들의 특징 News2026. 9. 16. 10:14


사회적 지능이 낮은 사람들의 특징

https://www.instagram.com/reel/Dc-zTdLxcYI/?stkn=YmhwdzcwcDcyYnhj

'News' 카테고리의 다른 글

아 IMF 눈물의 애국심  (0) 2026.09.15
야탑역 흉기난동 예고글 국가배상  (0) 2026.08.25
다정함을 위한 전쟁  (2) 2026.08.05
듣보잡 쓰레기의 최후  (0) 2026.08.05
50넘어 알게되는 인생조언  (2) 2026.07.25
:
Posted by Ritz®™

2026년 9월 3일 공개된 GPT-6 Astra의 성능·가격·안전성, 그리고 '추론 상태 보존' 하네스가 바꿔놓은 벤치마크의 의미

📅 발행일: 2026년 9월 15일 ・ 🏷️ 태그: #OpenAI #GPT6 #Astra #ARCAGI #AI보안 #프런티어모델 ・ 🔎 출처: OpenAI 공식 발표, Simon Willison's Weblog, TechStartups

섹션 이미지 1

📌 핵심 요약 (TL;DR)
- OpenAI가 2026년 9월 3일 GPT-6 Astra를 공개했습니다. 안전성·역공학·추론 부문에서 프런티어 모델의 새 기준을 제시한 모델입니다.
- 커스텀 'Provider Adapter 하네스' 를 사용했을 때 ARC-AGI 3에서 99.9% 를 기록했습니다(기본 하네스는 62.7%).
- 보안 벤치마크에서도 ExploitBench 100%, 4회 시도 내 SRE-Bench 바이너리 역공학 99.2% 를 달성했습니다.
- 가격은 경쟁사와 동일한 입력 100만 토큰당 $10 / 출력 $50 로 책정됐습니다.


1. GPT-6 Astra 등장 — 무엇이 달라졌나

2026년 9월 3일, OpenAI는 차세대 프런티어 모델 GPT-6 Astra를 발표했습니다. 이번 릴리스의 특징은 단순한 '더 똑똑한 모델'이 아니라, 추론 능력·보안 역량·안전성 평가를 동시에 끌어올린 것에 있습니다.

Astra는 다음 영역에서 눈에 띄는 개선을 보였습니다.

  • 추론과 계획: 장기 작업에서 목표를 유지하고 스스로 검증하는 능력 강화
  • 역공학(Reverse Engineering): 바이너리·프로토콜 분석 작업에서 실질적 성능 향상
  • 안전성: 고위험 요청을 분류·거부하는 정책 집행의 일관성 개선
  • 에이전트 실행: 도구 호출과 다단계 작업을 안정적으로 수행

특히 업계가 주목한 것은 벤치마크 점수의 '절대값'이 아니라 그것을 끌어올린 '측정 방식' 입니다. Astra의 ARC-AGI 3 성적은 모델 자체의 능력과 하네스(외부 오케스트레이션) 설계가 결합된 결과라는 점이 명확히 드러났습니다.

섹션 이미지 2

2. ARC-AGI 3에서 99.9% — 'Provider Adapter 하네스'의 의미

가장 논쟁적인 숫자는 ARC-AGI 3에서의 99.9% 입니다. 이는 'Provider Adapter 하네스' — 요청 간에 불투명한 추론 상태(opaque reasoning state)와 컴팩션(압축)을 보존하는 커스텀 래퍼 — 를 사용했을 때의 결과입니다.

측정 조건 ARC-AGI 3 점수 비용
기본 하네스 62.7% 상대적으로 저렴
Provider Adapter 하네스 99.9% 약 $19,000
차이 +37.2%p 대규모 추론 예산 소모

이 수치는 두 가지를 동시에 말해줍니다.

  1. 모델의 상한이 실제로 높아졌다 — 충분한 추론 예산과 상태 보존이 주어지면 거의 완벽에 가까운 성능이 나옵니다.
  2. '점수'는 이제 하네스 설계의 함수다 — 같은 모델도 어떻게 감싸느냐에 따라 성적이 37%p 이상 달라집니다.

실무 관점에서 이는 곧 엔지니어링 역량이 곧 성능이라는 뜻입니다. 모델을 그대로 호출하는 것과, 상태를 보존하고 추론 예산을 전략적으로 배분하는 것 사이에는 큰 격차가 존재합니다.

섹션 이미지 3

3. 보안 벤치마크 석권 — ExploitBench 100%, SRE-Bench 99.2%

Astra는 공격적 보안 역량을 측정하는 벤치마크에서도 강세를 보였습니다.

  • ExploitBench: 100%
  • SRE-Bench (바이너리 역공학): 99.2% (4회 시도 내)

이는 양날의 검입니다. 방어자에게는 취약점 분석·패치 검증을 자동화하는 강력한 도구가 되지만, 동시에 고위험 능력이 상용 API로 유통된다는 뜻이기도 합니다. 그래서 업계에서는 "Astra급 모델의 공격적 보안 역량을 어떻게 통제할 것인가"가 규제 논의의 핵심으로 떠올랐습니다.

경쟁사인 앤트로픽이 사실상 동일한 시기에 사이버·생명과학 특화 모델을 '검증된 기관'에만 제한 배포하는 전략을 택한 것과 대비되는 지점입니다.

섹션 이미지 4

4. 가격과 컨텍스트 — 입력 $10 / 출력 $50

가격 정책은 시장의 예상을 크게 벗어나지 않았습니다.

항목 사양
입력 가격 $10 / 100만 토큰
출력 가격 $50 / 100만 토큰
컨텍스트 윈도우 최대 약 100만 토큰
8-needle 테스트 256K–512K 구간 100%, 512K–1M 구간 96.3%

경쟁 모델과 사실상 동일한 가격대를 유지했다는 점은 프런티어 모델의 가격이 '수렴 구간'에 들어섰음을 시사합니다. 이제 경쟁의 축은 가격이 아니라 에이전트 워크로드에서의 실효 비용(캐시·추론 예산 포함) 으로 이동하고 있습니다.

섹션 이미지 5

5. 경쟁 구도와 시사점

GPT-6 Astra의 등장으로 2026년 9월 프런티어 진영은 사실상 3강 체제로 재편됐습니다.

진영 대표 모델 특징
OpenAI GPT-6 Astra 추론 상한·보안 역량, 동일 가격대
Anthropic Claude Fable 5.1 / Mythos 5.1 캐시 가격 인하·게이트 모델 전략
Google Gemini 3.8 Flash 초저가 인트로 가격·정부 전용 변형

실무자를 위한 정리

  • 단일 모델 의존은 리스크다 — 같은 작업도 모델·하네스 조합에 따라 비용과 성능이 크게 달라집니다.
  • 추론 예산은 새로운 '튜닝 파라미터'다 — 어려운 문제에 얼마를 쓸지 설계해야 합니다.
  • 보안 역량의 상용화는 규제 변수다 — 고위험 능력 모델의 접근 통제가 곧 컴플라이언스 이슈가 됩니다.

🔗 참고 자료

  • OpenAI GPT-6 Astra 발표: https://openai.com/index/gpt-6-astra/
  • Simon Willison's Weblog (2026-09-03): https://simonwillison.net/2026/Sep/3/gpt6-astra/
  • TechStartups Top Tech News (2026-09-02): https://techstartups.com/2026/09/02/top-tech-news-today-september-2-2026-anthropic-google-meta-nvidia-perplexity-openai-tencent-more/

이 글은 공개된 보도·발표 자료를 바탕으로 한국어로 정리·분석한 것입니다. 수치는 발표 시점 기준입니다.

:
Posted by Ritz®™

2023년 이후 누적 1.1조 달러, 올해만 7,450억 달러 추가… 투자 회수 시계가 흔드는 AI 인프라 경제학

📅 발행일: 2026년 9월 15일 ・ 🏷️ 태그: #AI투자 #CAPEX #데이터센터 #AI인프라 #빅테크 #전력 ・ 🔎 출처: TLT AI Brief, Financial Times, TechStartups

섹션 이미지 1

📌 핵심 요약 (TL;DR)
- 빅테크 하이퍼스케일러(구글·아마존·마이크로소프트·메타)의 AI 관련 누적 설비투자가 1조 1천억 달러를 돌파했습니다(2023년 이후).
- 올해에만 약 7,450억 달러가 데이터센터·전용 칩·전력망에 추가 투입될 전망입니다.
- 전력과 전력망이 새로운 병목으로 부상했습니다.
- 투자 회수 시점에 대한 주주 우려가 커지며, 'AI 골드러시'의 지속 가능성이 논쟁의 중심이 되었습니다.


1. 1.1조 달러 — 숫자의 의미

2026년 9월 초 재무·산업 분석에 따르면, 빅테크 하이퍼스케일러의 AI 인프라 누적 설비투자(CAPEX)가 1조 1천억 달러를 넘어섰습니다. 기준 시점은 2023년입니다.

이 숫자가 중요한 이유는 "AI가 이제 연구비가 아니라 산업 설비" 라는 점을 보여주기 때문입니다.

구분 규모
누적 AI 인프라 투자 (2023~) 1조 1천억 달러 초과
올해 추가 예정 약 7,450억 달러
주요 투자처 데이터센터, 전용 칩, 전력·냉각

이는 단일 기술 붐으로 보기 어려운 규모입니다. 국가 기간산업 수준의 자본 배분이 AI를 향하고 있습니다.

섹션 이미지 2

2. 올해만 7,450억 달러 — 어디에 쓰이나

추가 투입되는 약 7,450억 달러의 주요 항목은 다음과 같습니다.

  1. 데이터센터 건설 — 대규모 학습·추론 클러스터
  2. 전용 칩 — GPU·TPU·자체 가속기 확보
  3. 전력 인프라 — 발전·송전·냉각 설비
  4. 네트워크 — 클러스터 내부 연결(광·광모듈) 및 상호연결

특히 원가 구조의 중심이 '칩'에서 '전력+시설'로 확장되고 있습니다. 첨단 칩을 사는 것만으로는 클러스터를 돌릴 수 없기 때문입니다.

섹션 이미지 3

3. 전력과 전력망 — 새로운 병목

AI 인프라의 병목은 이제 전력입니다.

  • 대규모 클러스터는 수백 메가와트~기가와트급 전력을 소비합니다.
  • 전력망 증설은 수년이 걸리는 장기 프로젝트입니다.
  • 냉각·송전 인프라가 데이터센터 입지의 결정 요인이 됩니다.

이 때문에 최근 투자 흐름은 청정에너지·전력 인프라로까지 확장됐습니다. AI 경쟁이 곧 에너지 경쟁으로 번지는 양상입니다.

병목 배경 대응
전력 GW급 수요 발전·송전 투자, 청정에너지
냉각 발열 밀도 상승 액체 냉각 등 차세대 냉각
연결 클러스터 규모 확대 광 네트워킹·광모듈

섹션 이미지 4

4. 투자 회수 압박 — 주주 우려와 수익화 시계

문제는 투자 대비 수익화 속도입니다. CAPEX는 즉시 집행되지만, AI 제품·서비스의 수익은 시간을 두고 나타납니다.

주주들이 던지는 질문은 단순합니다.

  • 언제 수익화되는가?
  • 투자 회수 기간은 얼마인가?
  • 경쟁사보다 효율적인가?

이 때문에 기업들은 "얼마나 많이 짓는가"보다 "얼마나 효율적으로 쓰는가" 를 강조하기 시작했습니다. 자체 칩(메타 Iris 등), 모델 경량화, 캐시 최적화는 모두 같은 성능을 더 싸게 만들기 위한 대응입니다.

섹션 이미지 5

5. AI 인프라 사이클의 향방

'AI 거품론'과 '기반 투자론'은 계속 충돌하고 있습니다.

낙관론
- 추론 수요는 구조적으로 증가
- 인프라는 한번 지으면 장기 자산
- 전력·칩 산업에 파급 효과

신중론
- 회수 기간 불확실
- 감가상각·전력 비용 부담
- 모델 효율화로 수요 곡선이 꺾일 가능성

실무자를 위한 정리

  • 원가를 '작업 단위'로 관리하라 — 토큰 단가가 아니라 태스크당 비용이 기준입니다.
  • 효율이 곧 경쟁력이다 — 캐싱·경량화·자체 칩이 수익성을 좌우합니다.
  • 전력을 인프라 지표로 보라 — AI 사이클은 에너지 사이클과 함께 움직입니다.

🔗 참고 자료

  • TLT LLP — AI Brief (2026년 9월): https://www.tlt.com/insights-and-events/insight/tlts-ai-brief-september-2026
  • TechStartups Top Tech News (2026-09-02): https://techstartups.com/2026/09/02/top-tech-news-today-september-2-2026-anthropic-google-meta-nvidia-perplexity-openai-tencent-more/

이 글은 공개된 보도·분석 자료를 바탕으로 한국어로 정리·분석한 것입니다. 수치는 발표 시점 기준입니다.

:
Posted by Ritz®™

도구 호출 20% 감소, 최대 145조 원 규모 CAPEX… 빅테크 '커스텀 실리콘' 경쟁의 분기점

📅 발행일: 2026년 9월 15일 ・ 🏷️ 태그: #Meta #MuseSpark #AI칩 #커스텀실리콘 #데이터센터 #AI인프라 ・ 🔎 출처: Digital Applied 모델 트래커, Yahoo Finance/Quartz, AWS Weekly Roundup

섹션 이미지 1

📌 핵심 요약 (TL;DR)
- 메타가 2026년 9월 2일 Muse Spark 1.3 를 공개했습니다. 실행 전 확인 질문을 던지는 에이전트 특화 모델입니다.
- 버전 1.2 대비 도구 호출(tool call)을 약 20% 줄였습니다. 비용과 지연을 동시에 낮추는 변화입니다.
- 자체 AI 가속기 'Iris'(MTIA 프로그램)가 2026년 9월 양산에 들어갔습니다.
- 메타의 2026년 컴퓨팅 규모는 7기가와트, 2027년 14기가와트 목표이며 CAPEX는 최대 1,450억 달러 규모입니다.


1. Muse Spark 1.3 — '확인하고 실행하는' 에이전트 모델

메타가 Muse Spark 1.3 을 발표했습니다. 이 모델의 설계 철학은 명확합니다. "중요한 작업을 실행하기 전에 되묻고 검증한다."

에이전트가 무작정 도구를 호출하는 대신,

  • 목표가 모호하면 확인 질문을 던지고
  • 실행 전 결과를 검증하며
  • 불필요한 호출을 줄입니다

가격은 입력 $1.25 / 출력 $4.25(100만 토큰당)로 유지됐고, 기여형 학습 티어($0.10 / $0.20) 도 함께 제공됩니다. 저렴한 단가로 에이전트 대량 배포를 노리는 포지션입니다.

섹션 이미지 2

2. 도구 호출 20% 감소가 의미하는 것

에이전트 시스템에서 도구 호출은 곧 비용입니다. 외부 API 호출, 검색, 코드 실행은 모두 시간과 돈을 소모합니다.

Muse Spark 1.3의 도구 호출 약 20% 감소는 다음을 뜻합니다.

항목 효과
지연(Latency) 호출 수 감소 → 응답 빨라짐
비용 외부 API·추론 토큰 절감
신뢰성 불필요한 호출·오류 경로 축소

이는 "더 똑똑한 모델"보다 "더 효율적인 에이전트" 가 프로덕션에서 더 중요해졌다는 신호입니다. 화려한 추론 능력보다 적은 호출로 정확한 결과를 내는 것이 실무 성과를 좌우합니다.

섹션 이미지 3

3. 자체 AI 칩 Iris — MTIA 프로그램의 진화

하드웨어 측면에서 메타의 자체 AI 가속기 'Iris'2026년 9월 볼륨 생산에 들어갔습니다. Iris는 메타의 MTIA(Meta Training and Inference Accelerator) 프로그램 산하에 있습니다.

배경은 명확합니다.

  • 엔비디아·AMD GPU 의존은 공급·가격 양면에서 리스크
  • 추론(inference) 워크로드는 전용 칩으로 최적화 가능
  • 대규모 클러스터에서 전력당 성능이 핵심 지표

커스텀 실리콘은 "GPU를 대체" 하기보다 "추론 비용을 낮추는 보완재" 로 자리잡고 있습니다. 브로드컴 등과의 설계 협력도 이 흐름을 뒷받침합니다.

섹션 이미지 4

4. 7기가와트 → 14기가와트 — 인프라 로드맵

메타의 컴퓨팅 확장 계획은 규모 자체가 메시지입니다.

연도 컴퓨팅 규모 CAPEX
2026 7기가와트 최대 1,450억 달러
2027 14기가와트 추가 확대

여기서 기가와트(GW) 라는 단위가 중요합니다. AI 인프라의 병목이 이제 "칩"에서 "전력" 으로 옮겨갔다는 뜻이기 때문입니다. 데이터센터를 지어도 전력이 없으면 돌릴 수 없습니다.

섹션 이미지 5

5. 커스텀 실리콘 경쟁과 시사점

2026년 9월 기준 커스텀 AI 실리콘 경쟁 구도를 정리하면 다음과 같습니다.

기업 자체 칩 상태
Meta Iris (MTIA) 2026년 9월 양산 시작
Google TPU 세대별 지속 업데이트
Amazon Graviton / Trainium Graviton5 기반 인스턴스 공개
Broadcom 설계 파트너 메타·클라우드 고객 확대

실무자를 위한 정리

  • 추론 비용을 최적화하라 — 에이전트 도구 호출을 줄이는 것만으로도 큰 절감이 됩니다.
  • 전력을 인프라 지표로 보라 — GPU 수량보다 전력·전력당 성능이 중요해졌습니다.
  • 칩 공급망 다변화를 이해하라 — 자체 칩은 리스크 헤지이자 원가 전략입니다.

🔗 참고 자료

  • Digital Applied — 2026년 9월 AI 모델 릴리스 트래커: https://www.digitalapplied.com/blog/ai-model-releases-september-2026-tracker
  • Yahoo Finance / Quartz — 메타 Iris AI 칩 양산: https://finance.yahoo.com/technology/ai/articles/meta-start-production-iris-ai-122141801.html
  • AWS Weekly Roundup (2026-09-07): https://aws.amazon.com/blogs/aws/aws-weekly-roundup-claude-fable-5-1-on-aws-amazon-linux-2027-preview-aws-certified-ai-business-strategist-and-more-september-7-2026/

이 글은 공개된 발표·보도 자료를 바탕으로 한국어로 정리·분석한 것입니다.

:
Posted by Ritz®™

백만 토큰 컨텍스트, 인트로 가격 $0.75/$3.75… 2027년 1월 가격 인상이 API 빌더에게 던지는 질문

📅 발행일: 2026년 9월 15일 ・ 🏷️ 태그: #Google #Gemini #GeminiFlash #Fairwind #AI가격 #LLMAPI ・ 🔎 출처: Google DeepMind, Digital Applied 모델 트래커, TechStartups

섹션 이미지 1

📌 핵심 요약 (TL;DR)
- 구글이 2026년 9월 2일 Gemini 3.8 Flash 를 공개했습니다. 6주 만의 세 번째 Flash 릴리스입니다.
- 컨텍스트 윈도우는 1,048,576 토큰(약 100만) 입니다.
- 인트로 가격은 입력 $0.75 / 출력 $3.75(100만 토큰당)이며, 2027년 1월 1일부터 두 배로 인상됩니다.
- Gemini 3.8 Flash Cyber 변형은 신설 'Fairwind 프로그램' 을 통해 정부·핵심 인프라 기관에만 배포됩니다.


1. Gemini 3.8 Flash — 빠른 티어의 진화

구글 딥마인드가 Gemini 3.8 Flash 를 발표했습니다. 6주 안에 세 번째 Flash를 내놓은 셈으로, '빠르고 저렴한 모델'을 최전선에서 갱신하는 구글의 전략이 뚜렷합니다.

Flash 라인의 가치는 다음과 같습니다.

  • 처리량(throughput): 대량 요청을 빠르게 소화
  • 지연(latency): 실시간·대화형 애플리케이션에 적합
  • 비용: 프런티어 모델 대비 낮은 단가

대규모 파이프라인, RAG 검색, 분류·요약 같은 작업에서 Flash는 사실상 기본 인프라로 자리잡았습니다.

섹션 이미지 2

2. 100만 토큰 컨텍스트 — 장문 처리의 실전 가치

Gemini 3.8 Flash의 컨텍스트 윈도우는 1,048,576 토큰 입니다.

항목 사양
컨텍스트 1,048,576 토큰
입력 가격 (인트로) $0.75 / 100만 토큰
출력 가격 (인트로) $3.75 / 100만 토큰
인트로 종료 2026년 12월 31일
이후 가격 입력 $1.50 / 출력 $7.50

100만 토큰 컨텍스트가 실무에서 중요한 이유는 "청킹(chunking) 설계 부담" 을 줄여주기 때문입니다. 문서 전체, 대규모 코드베이스, 장시간 회의 로그를 한 번에 넣고 처리할 수 있습니다.

섹션 이미지 3

3. 인트로 가격과 2027년 인상 — 무엇을 준비해야 하나

이번 릴리스에서 주목할 지점은 가격 인상 예고입니다.

기간 입력 출력
2026-09-02 ~ 2026-12-31 $0.75 $3.75
2027-01-01 ~ $1.50 $7.50

약 4개월간의 '인트로 가격' 기간 이후 단가가 두 배가 됩니다. API 기반 제품을 운영하는 팀이라면 다음을 준비해야 합니다.

  1. 단가 민감도 분석 — 전체 비용에서 해당 모델 비중을 계산
  2. 캐싱·배치 전략 — 재사용과 일괄 처리를 통한 토큰 절감
  3. 모델 추상화 레이어 — 특정 모델에 락인되지 않는 설계
  4. 가격 시뮬레이션 — 2027년 1월 시나리오 반영한 요금제 재계산

섹션 이미지 4

4. Flash Cyber와 Fairwind — 정부·핵심 인프라 전용 변형

구글은 표준 Flash와 함께 Gemini 3.8 Flash Cyber 를 공개했습니다. 일반 모델보다 완화책(mitigations)을 느슨하게 조정한 변형으로, 신설된 'Fairwind 프로그램' 을 통해 정부 및 핵심 인프라 운영 기관에만 제공됩니다.

이는 앤트로픽의 '게이트 모델' 전략과 같은 방향입니다.

진영 통제 방식
Anthropic Mythos 5.1 — 검증된 기관 전용
Google Flash Cyber — Fairwind 프로그램 (정부·핵심 인프라)
OpenAI Astra — 범용 공개 + 안전 정책 집행

프런티어 역량이 커질수록 "누구에게 열어줄 것인가" 가 제품 전략의 핵심 축이 되고 있습니다.

섹션 이미지 5

5. 모델 라인업 경쟁과 시사점

2026년 9월 기준 빠른 티어 경쟁 구도를 정리하면 다음과 같습니다.

제공자 모델 포지션
Google Gemini 3.8 Flash 최저가 인트로 + 100만 컨텍스트
Meta Muse Spark 1.3 도구 호출 절감형 에이전트
Anthropic Claude Fable 5.1 에이전트 실효 비용 절감
OpenAI GPT-6 Astra 추론 상한·보안 역량

실무자를 위한 정리

  • 가격 인상 일정을 캘린더에 넣어라 — 2027년 1월은 많은 팀의 원가 구조가 바뀌는 시점입니다.
  • 컨텍스트를 '설계 자원'으로 써라 — 100만 토큰은 청킹 부담을 줄여줍니다.
  • 접근 통제 모델을 파악하라 — 고위험 역량 모델은 별도 승인 경로가 필요합니다.

🔗 참고 자료

  • Digital Applied — 2026년 9월 AI 모델 릴리스 트래커: https://www.digitalapplied.com/blog/ai-model-releases-september-2026-tracker
  • Google DeepMind Gemini: https://deepmind.google/technologies/gemini/
  • TechStartups Top Tech News (2026-09-02): https://techstartups.com/2026/09/02/top-tech-news-today-september-2-2026-anthropic-google-meta-nvidia-perplexity-openai-tencent-more/

이 글은 공개된 발표·보도 자료를 바탕으로 한국어로 정리·분석한 것입니다. 가격·일정은 발표 시점 기준입니다.

:
Posted by Ritz®™

캐시 읽기 가격 75% 인하, 사이버·생명과학 특화 모델은 '검증된 기관'에만 — 프런티어 AI의 이중 전략을 읽는다

📅 발행일: 2026년 9월 15일 ・ 🏷️ 태그: #Anthropic #Claude #Fable5 #Mythos #AI에이전트 #캐시가격 ・ 🔎 출처: Anthropic 공식 발표, AWS Weekly Roundup, TechStartups
섹션 이미지 1

📌 핵심 요약 (TL;DR)
- 앤트로픽이 2026년 9월 1일 Claude Fable 5.1(일반 공개)과 Mythos 5.1(제한 배포)를 동시에 발표했습니다.
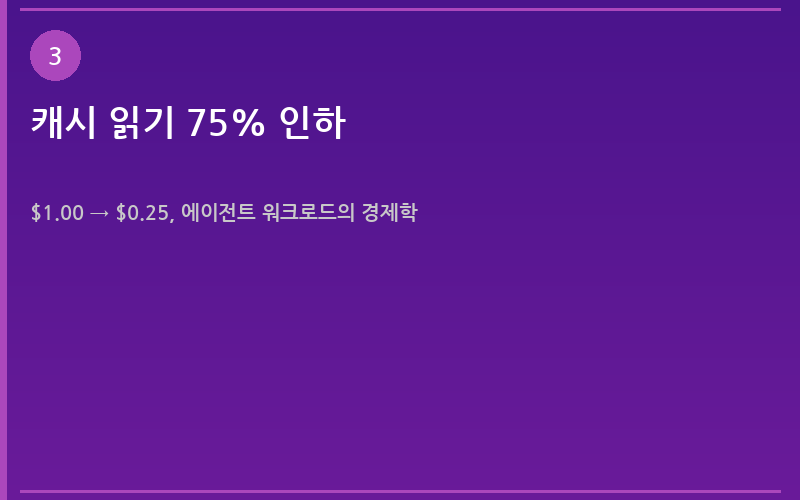
- 에이전트 워크로드 비용을 최대 45% 절감했고, 캐시 읽기 가격을 75% 인하했습니다($1.00 → $0.25 / 100만 토큰).
- 표준 가격은 입력 $10 / 출력 $50 로 유지했습니다.
- 사이버·생명과학 고위험 역량을 가진 모델은 검증된 기관에만 제공하는 '게이트 모델' 전략을 택했습니다.


1. Fable 5.1 — 에이전트·코딩·장기 추론의 업그레이드

앤트로픽의 주력 모델 Claude Fable 5.1 이 일반 공개되었습니다. 이번 버전의 초점은 명확합니다.

  • 에이전트 코딩: 다단계 리팩터링, 테스트 작성, 디버깅 루프의 안정성 향상
  • 장기 실행 문제 해결: 긴 세션에서 목표를 잃지 않고 이어가는 능력 강화
  • 다학제 추론: 과학·수학·법률 등 복합 도메인 질의에서의 일관성 개선

핵심은 "더 어려운 일을, 더 싸게" 입니다. 특히 에이전트가 스스로 도구를 호출하고 검증하는 워크로드에서 실효 비용이 크게 낮아졌습니다.

섹션 이미지 2

2. Mythos 5.1 — 왜 제한 배포인가

같은 날 공개된 Claude Mythos 5.1 은 일반 사용자에게 열려 있지 않습니다. 사이버보안과 생명과학 분야의 고급 역량을 보유한 탓에, 검증된 조직(vetted organizations)에게만 제공됩니다.

이는 프런티어 AI 진영의 새로운 패턴을 보여줍니다.

구분 일반 모델 (Fable 5.1) 게이트 모델 (Mythos 5.1)
접근 누구나 검증된 기관만
역량 범용 코딩·추론 사이버·생명과학 고위험
규제 대응 표준 통제된 프런티어 배포

즉, "능력을 낮추는 대신 접근을 통제한다" 는 전략입니다. 모델 성능을 깎아 안전을 확보하는 대신, 고위험 능력은 유지하되 문을 좁히는 방식입니다.
섹션 이미지 3

3. 캐시 읽기 75% 인하 — 에이전트 워크로드의 경제학

이번 릴리스에서 실무자에게 가장 직접적인 변화는 가격 구조입니다.

항목 이전 이후
입력 $10 / 100만 토큰 $10 / 100만 토큰
출력 $50 / 100만 토큰 $50 / 100만 토큰
캐시 읽기 $1.00 / 100만 토큰 $0.25 / 100만 토큰 (−75%)

에이전트는 같은 컨텍스트를 수십 번 재사용합니다. 시스템 프롬프트, 코드베이스, 이전 대화가 매 턴마다 다시 읽히기 때문입니다. 따라서 캐시 읽기 단가가 에이전트의 실효 비용을 좌우합니다.

결과적으로 앤트로픽은 에이전트 워크로드 비용을 최대 45% 절감했다고 밝혔습니다. 이는 "토큰 단가"가 아니라 "작업 단위 비용" 경쟁으로 시장이 이동하고 있음을 보여줍니다.
섹션 이미지 4

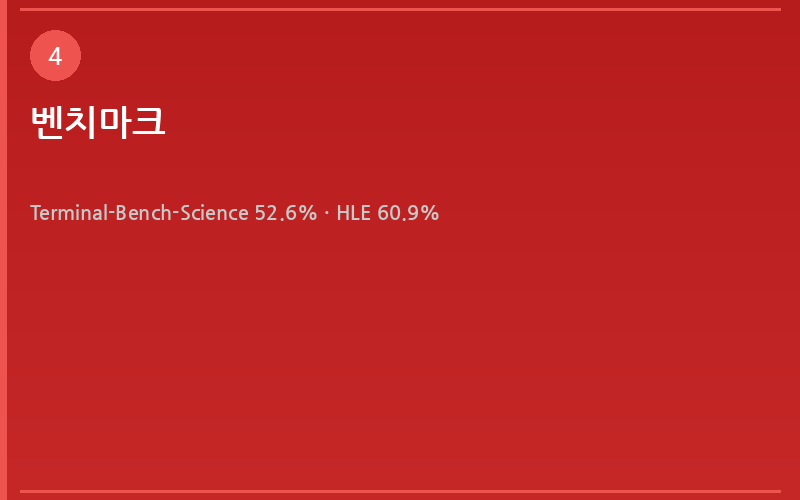
4. 벤치마크 — Terminal-Bench-Science 52.6% · HLE 60.9%

Fable 5.1의 공개 벤치마크는 다음과 같습니다.

벤치마크 점수 의미
Terminal-Bench-Science 0.1 52.6% 터미널 기반 과학 워크플로 수행
Humanity's Last Exam (no tools) 60.9% 도구 없이 최고난도 지식 추론

특히 도구 없이 60.9% 라는 점이 눈에 띕니다. 에이전트 오케스트레이션 없이 순수 모델 추론만으로 측정한 값이기 때문에, 기반 모델의 지식·추론 밀도가 얼마나 높아졌는지를 보여줍니다.
섹션 이미지 5

5. 기업용 세이프가드와 시사점 — '통제된 프런티어'

앤트로픽은 이번 릴리스와 함께 EFS(Enterprise Frontier Safeguards) 를 도입했습니다. 엔터프라이즈 고객의 데이터 프라이버시와 컴플라이언스를 강화하는 프레임워크입니다.

정리하면 앤트로픽의 전략은 3중 구조입니다.

  1. 일반 시장: Fable 5.1로 성능·가격 경쟁
  2. 고위험 역량: Mythos 5.1을 게이트 모델로 통제 배포
  3. 엔터프라이즈: EFS로 데이터 거버넌스 제공

실무자를 위한 정리

  • 캐시를 설계하라 — 프롬프트 캐싱 구조가 곧 비용 절감의 핵심입니다.
  • 모델 티어를 분리하라 — 범용 작업과 고위험 작업에 다른 모델을 배치하세요.
  • 접근 통제를 준비하라 — 고위험 역량 모델은 조직 내 승인 절차가 필요합니다.

🔗 참고 자료

  • Anthropic 공식 발표: https://www.anthropic.com/claude-fable-and-mythos-5-1
  • AWS Weekly Roundup (2026-09-07): https://aws.amazon.com/blogs/aws/aws-weekly-roundup-claude-fable-5-1-on-aws-amazon-linux-2027-preview-aws-certified-ai-business-strategist-and-more-september-7-2026/
  • TechStartups Top Tech News (2026-09-02): https://techstartups.com/2026/09/02/top-tech-news-today-september-2-2026-anthropic-google-meta-nvidia-perplexity-openai-tencent-more/

이 글은 공개된 발표·보도 자료를 바탕으로 한국어로 정리·분석한 것입니다.

:
Posted by Ritz®™

2026년 9월 3일 공개된 GPT-6 Astra의 성능·가격·안전성, 그리고 '추론 상태 보존' 하네스가 바꿔놓은 벤치마크의 의미

📅 발행일: 2026년 9월 15일 ・ 🏷️ 태그: #OpenAI #GPT6 #Astra #ARCAGI #AI보안 #프런티어모델 ・ 🔎 출처: OpenAI 공식 발표, Simon Willison's Weblog, TechStartups

섹션 이미지 1

📌 핵심 요약 (TL;DR)
- OpenAI가 2026년 9월 3일 GPT-6 Astra를 공개했습니다. 안전성·역공학·추론 부문에서 프런티어 모델의 새 기준을 제시한 모델입니다.
- 커스텀 'Provider Adapter 하네스' 를 사용했을 때 ARC-AGI 3에서 99.9% 를 기록했습니다(기본 하네스는 62.7%).
- 보안 벤치마크에서도 ExploitBench 100%, 4회 시도 내 SRE-Bench 바이너리 역공학 99.2% 를 달성했습니다.
- 가격은 경쟁사와 동일한 입력 100만 토큰당 $10 / 출력 $50 로 책정됐습니다.


1. GPT-6 Astra 등장 — 무엇이 달라졌나

2026년 9월 3일, OpenAI는 차세대 프런티어 모델 GPT-6 Astra를 발표했습니다. 이번 릴리스의 특징은 단순한 '더 똑똑한 모델'이 아니라, 추론 능력·보안 역량·안전성 평가를 동시에 끌어올린 것에 있습니다.

Astra는 다음 영역에서 눈에 띄는 개선을 보였습니다.

  • 추론과 계획: 장기 작업에서 목표를 유지하고 스스로 검증하는 능력 강화
  • 역공학(Reverse Engineering): 바이너리·프로토콜 분석 작업에서 실질적 성능 향상
  • 안전성: 고위험 요청을 분류·거부하는 정책 집행의 일관성 개선
  • 에이전트 실행: 도구 호출과 다단계 작업을 안정적으로 수행

특히 업계가 주목한 것은 벤치마크 점수의 '절대값'이 아니라 그것을 끌어올린 '측정 방식' 입니다. Astra의 ARC-AGI 3 성적은 모델 자체의 능력과 하네스(외부 오케스트레이션) 설계가 결합된 결과라는 점이 명확히 드러났습니다.

섹션 이미지 2

2. ARC-AGI 3에서 99.9% — 'Provider Adapter 하네스'의 의미

가장 논쟁적인 숫자는 ARC-AGI 3에서의 99.9% 입니다. 이는 'Provider Adapter 하네스' — 요청 간에 불투명한 추론 상태(opaque reasoning state)와 컴팩션(압축)을 보존하는 커스텀 래퍼 — 를 사용했을 때의 결과입니다.

측정 조건 ARC-AGI 3 점수 비용
기본 하네스 62.7% 상대적으로 저렴
Provider Adapter 하네스 99.9% 약 $19,000
차이 +37.2%p 대규모 추론 예산 소모

이 수치는 두 가지를 동시에 말해줍니다.

  1. 모델의 상한이 실제로 높아졌다 — 충분한 추론 예산과 상태 보존이 주어지면 거의 완벽에 가까운 성능이 나옵니다.
  2. '점수'는 이제 하네스 설계의 함수다 — 같은 모델도 어떻게 감싸느냐에 따라 성적이 37%p 이상 달라집니다.

실무 관점에서 이는 곧 엔지니어링 역량이 곧 성능이라는 뜻입니다. 모델을 그대로 호출하는 것과, 상태를 보존하고 추론 예산을 전략적으로 배분하는 것 사이에는 큰 격차가 존재합니다.

섹션 이미지 3

3. 보안 벤치마크 석권 — ExploitBench 100%, SRE-Bench 99.2%

Astra는 공격적 보안 역량을 측정하는 벤치마크에서도 강세를 보였습니다.

  • ExploitBench: 100%
  • SRE-Bench (바이너리 역공학): 99.2% (4회 시도 내)

이는 양날의 검입니다. 방어자에게는 취약점 분석·패치 검증을 자동화하는 강력한 도구가 되지만, 동시에 고위험 능력이 상용 API로 유통된다는 뜻이기도 합니다. 그래서 업계에서는 "Astra급 모델의 공격적 보안 역량을 어떻게 통제할 것인가"가 규제 논의의 핵심으로 떠올랐습니다.

경쟁사인 앤트로픽이 사실상 동일한 시기에 사이버·생명과학 특화 모델을 '검증된 기관'에만 제한 배포하는 전략을 택한 것과 대비되는 지점입니다.

섹션 이미지 4

4. 가격과 컨텍스트 — 입력 $10 / 출력 $50

가격 정책은 시장의 예상을 크게 벗어나지 않았습니다.

항목 사양
입력 가격 $10 / 100만 토큰
출력 가격 $50 / 100만 토큰
컨텍스트 윈도우 최대 약 100만 토큰
8-needle 테스트 256K–512K 구간 100%, 512K–1M 구간 96.3%

경쟁 모델과 사실상 동일한 가격대를 유지했다는 점은 프런티어 모델의 가격이 '수렴 구간'에 들어섰음을 시사합니다. 이제 경쟁의 축은 가격이 아니라 에이전트 워크로드에서의 실효 비용(캐시·추론 예산 포함) 으로 이동하고 있습니다.

섹션 이미지 5

5. 경쟁 구도와 시사점

GPT-6 Astra의 등장으로 2026년 9월 프런티어 진영은 사실상 3강 체제로 재편됐습니다.

진영 대표 모델 특징
OpenAI GPT-6 Astra 추론 상한·보안 역량, 동일 가격대
Anthropic Claude Fable 5.1 / Mythos 5.1 캐시 가격 인하·게이트 모델 전략
Google Gemini 3.8 Flash 초저가 인트로 가격·정부 전용 변형

실무자를 위한 정리

  • 단일 모델 의존은 리스크다 — 같은 작업도 모델·하네스 조합에 따라 비용과 성능이 크게 달라집니다.
  • 추론 예산은 새로운 '튜닝 파라미터'다 — 어려운 문제에 얼마를 쓸지 설계해야 합니다.
  • 보안 역량의 상용화는 규제 변수다 — 고위험 능력 모델의 접근 통제가 곧 컴플라이언스 이슈가 됩니다.

🔗 참고 자료

  • OpenAI GPT-6 Astra 발표: https://openai.com/index/gpt-6-astra/
  • Simon Willison's Weblog (2026-09-03): https://simonwillison.net/2026/Sep/3/gpt6-astra/
  • TechStartups Top Tech News (2026-09-02): https://techstartups.com/2026/09/02/top-tech-news-today-september-2-2026-anthropic-google-meta-nvidia-perplexity-openai-tencent-more/

이 글은 공개된 보도·발표 자료를 바탕으로 한국어로 정리·분석한 것입니다. 수치는 발표 시점 기준입니다.
:
Posted by Ritz®™
2026. 9. 15. 02:06

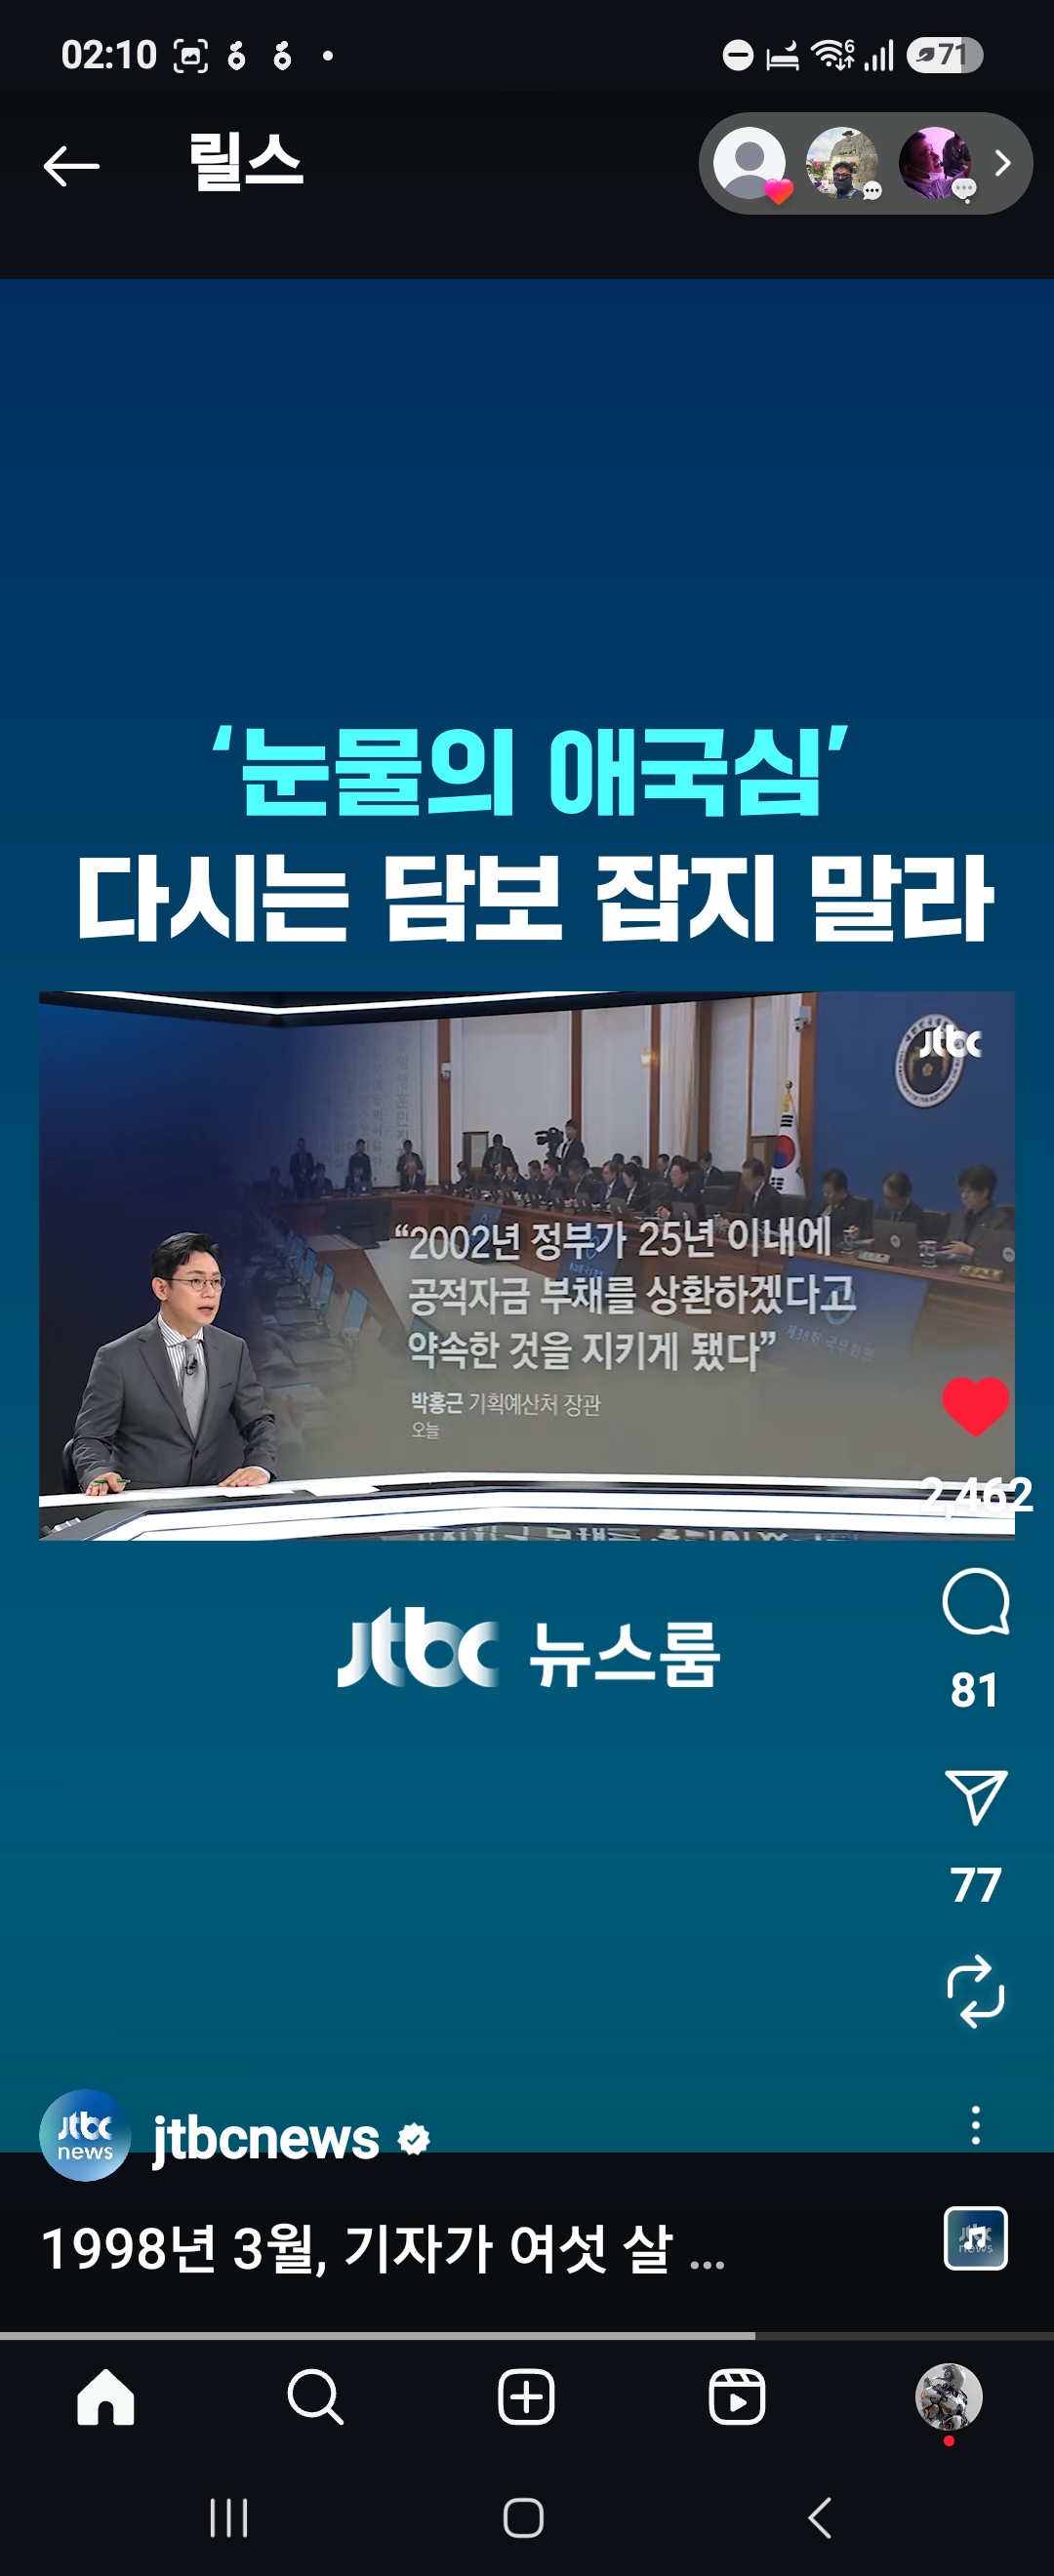
아 IMF 눈물의 애국심 News2026. 9. 15. 02:06


다국적기업에 근무중이던 나는 이스라엘 과 유럽에 상주중이었다.
당시 홍해와 지중해를 오가며 친구들과 휴가를 즐기고 있었는데
어느날 아침 스웨덴 출신 앙드레가 호들갑을 떨며 나를 불렀다.
너네 IMF  탈출했다고

가슴이 먹먹해지며 의구심이 든건 나뿐만이 아니었다. 영국 출신 Tommy 가 영국과 브라질 조차도 각각 5년 7년 이상 걸리는 걸

벌써? 그 쬐그만 경제인구 2,700만인 나라가?

곧이어 CNN 뉴스와 월스트리트 신문을 읽으며 재차 확인하였었다.


https://www.instagram.com/reel/DcxW1iuAgte/?stkn=MXJocnQwaHZobXZmaQ==


'News' 카테고리의 다른 글

사회적 지능이 낮은 사람들의 특징  (0) 2026.09.16
야탑역 흉기난동 예고글 국가배상  (0) 2026.08.25
다정함을 위한 전쟁  (2) 2026.08.05
듣보잡 쓰레기의 최후  (0) 2026.08.05
50넘어 알게되는 인생조언  (2) 2026.07.25
:
Posted by Ritz®™